数据中台这个话题在 AI 时代正在被重新定义——它不再是大厂专属的重资产投入,而是每一个准备认真应用 AI 的企业绕不开的基础设施。
当前很多企业都在积极探索 AI 的应用落地,然而很多应用场景都面临一个尴尬问题:AI 应用难以有效获取企业内部的高质量业务数据,要么缺乏统一的数据出口,要么数据格式难以对齐,直接导致企业的 AI 应用无法真正的落地。
究其根源,数据中台建设的缺失已成为制约企业 AI 发展的关键瓶颈,其在 AI 时代已从"可选项"转变为"必选项"。
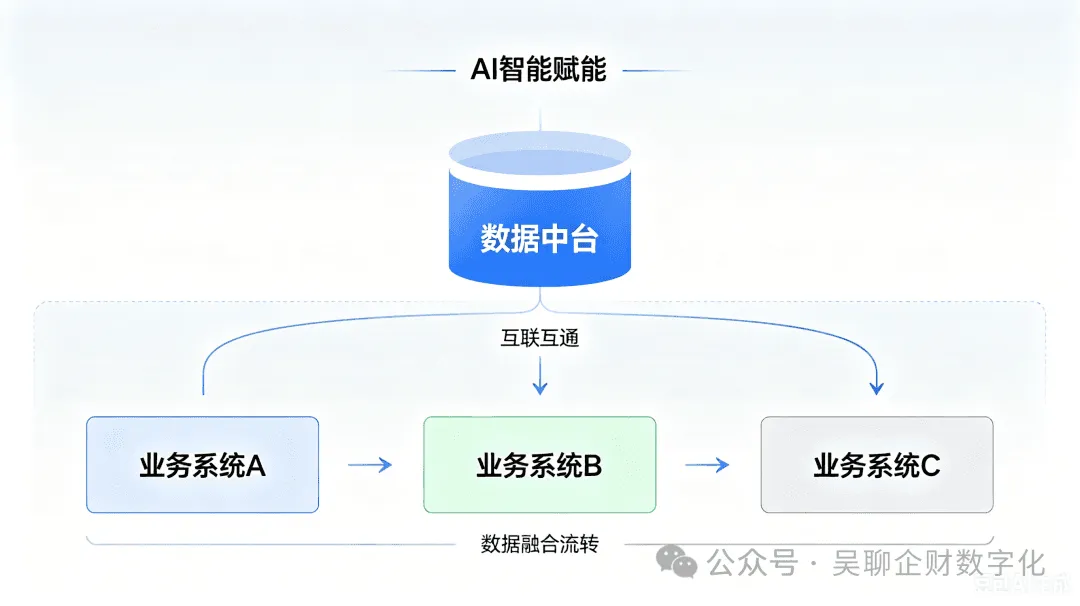
一、为什么数据中台是 AI 应用的基石
1.1 打破数据孤岛:从"多源异构"到"统一资产"
在企业运营过程中,业务系统、财务系统、人力资源系统等各自积累了海量数据。然而这些数据往往分散存储、格式各异、标准不一,形成了众多"数据孤岛"。
数据中台通过统一的数据标准和治理体系,将这些分散的数据整合为一致、准确的数据资产。
1.2 构建企业数据地图,沉淀组织知识
数据中台帮助企业梳理自身的数据资产,明确数据的分布、含义、来源与流向。这种"企业数据地图"实际上是一种组织知识的沉淀。
| 无数据中台 | 有数据中台 |
|---|---|
| 数据存储在各业务系统,依赖个人经验了解数据位置 | 统一数据资产目录,数据分布清晰可查 |
| 同名指标在不同系统口径不一致,决策易产生分歧 | 指标口径统一管理,各部门"说同一种语言" |
| 数据理解依赖口口相传,人员流动导致知识流失 | 数据含义、来源、流向显性化,成为组织资产 |
1.3 为 AI 提供高质量数据底座
AI 应用的效果高度依赖于数据质量。无论是机器学习模型的训练,还是大模型 RAG 知识库的检索,都需要高质量的数据作为支撑。
数据中台在数据汇聚过程中,通过数据清洗、标准化处理、质量监控等机制,为 AI 应用提供"干净、可用、可信"的数据底座。
- ✅ 统一数据源:避免 AI 从多个异构系统中重复取数
- ✅ 统一指标口径:让 AI 的分析结果与业务人员的理解一致
- ✅ 历史数据沉淀:为模型训练提供充足的历史样本
二、数据中台赋能 AI 的三大典型模式
在实践过程中,数据中台与 AI 的结合主要有以下几种方式:
2.1 数据服务化:让 AI 应用快速取数
数据中台将企业的核心数据(如客户、供应商、物料、科目余额、订单等)加工成标准化的数据服务。AI 应用(如智能问答、报表机器人、Agent)可以直接调用这些服务获取数据。
- ✅ 无需为每个 AI 应用单独开发取数接口,缩短开发周期
- ✅ 数据口径统一,避免"同名不同义"的分析结果
2.2 知识沉淀:构建企业级知识库
数据中台不仅管理结构化数据,还可以整合企业的非结构化数据(如制度文件、会议纪要、合同文本等)。
这些内容经过清洗和标签化处理后,可以作为大模型 RAG(检索增强生成)的知识库来源。
- ✅ 让 AI 不止"懂数据",还能"懂业务、懂制度"
- ✅ 提高问答类 AI 的准确度,减少模型幻觉
2.3 特征沉淀:为智能分析提供弹药
在财务预测、资金预测、销量预测等 AI 分析场景中,特征工程往往决定了模型效果的上限。
数据中台沉淀的指标体系(如历史费用率、回款周期、库存周转率等),可以直接作为 AI 模型的特征输入。
- ✅ 特征可复用,避免重复开发
- ✅ 特征口径统一,模型结果可解释、可追溯
三、AI 时代数据中台的新内涵
随着大模型技术的成熟,数据中台的定位也在发生变化——从"面向报表"转向"面向 AI"。
3.1 从"人找数"到"数找人"
传统数据平台的核心场景是"人找数":业务人员提需求,数据团队开发报表,用户在固定页面查看结果。
而 AI 时代的新场景是"数找人":
用户直接用自然语言提问,AI 自动理解意图、获取数据、生成分析结论。
这要求中台在服务能力上升级为语义层 / 指标层 / API 服务,让大模型能"读懂"数据。
3.2 中台 + AI 的协同闭环
- 中台供给 AI:清洗后的数据、统一指标、知识库内容,成为大模型的核心燃料
- AI 反哺中台:利用大模型辅助数据治理(如自动识别字段含义、生成数据标签、编写数据质量规则),降低中台建设成本
四、企业如何启动数据中台建设
很多中小企业会认为数据中台是大厂专属的"重资产"投入。事实上,在 AI 时代,数据中台的建设可以更加轻量。
- ✅ 从核心场景切入:不必一次性覆盖全业务,优先选择 AI 落地价值最高的领域(如财务分析、供应链分析)
- ✅ 利用开源工具:如 Apache Doris、DataEase 等,成本远低于传统商业方案
- ✅ 先统一指标,再建平台:指标口径的统一是数据中台的核心价值,先梳理指标,再逐步完善工具链
- ✅ 与大模型应用同步规划:数据中台建设时就考虑为 AI 提供服务(如预留语义层、知识库接口)
五、与传统数仓的区别
很多财务人员或业务人员不太理解数据中台与传统数据仓库(数仓)的区别,下面做一个简单的说明。
5.1 定义与定位
数据仓库(Data Warehouse)
- 定义:面向主题的、集成的、相对稳定的、反映历史变化的数据集合,用于支持管理决策。
- 核心定位:数据的存储与加工,重点是"把数据整理好、算清楚"。
- 典型产物:报表、多维分析、指标汇总。
- 服务对象:以数据分析师、IT 部门为主。
数据中台(Data Middle Platform)
- 定义:一套让企业数据"可用的"能力和机制集合,包括数据技术、数据治理、数据服务、数据资产运营。
- 核心定位:数据的资产化与服务化,重点是"让数据可以被业务和系统高效使用"。
- 典型产物:数据服务 API、指标体系、标签体系、统一数据资产目录。
- 服务对象:业务部门、应用系统、AI 应用等全企业。
| 维度 | 数据仓库 | 数据中台 |
|---|---|---|
| 核心目标 | 支撑报表与分析 | 数据资产化 + 服务化,赋能业务与 AI |
| 服务方式 | 取数、报表、看板 | API / 指标 / 标签 / 知识库服务 |
| 数据范围 | 以结构化业务数据为主 | 结构化 + 非结构化(文件、日志等) |
| 与 AI 关系 | 间接(提供训练数据) | 直接(为 AI 提供知识库与数据服务) |
| 建设理念 | 项目导向 | 资产与运营导向 |
5.2 三重困境的应对对比
AI 应用落地过程中普遍面临三重困境:数据口径不一致、数据质量参差、取数链路过长。
| 维度 | 传统数仓模式 | 中台化模式 |
|---|---|---|
| 口径管理 | 口径分散在报表和取数脚本中,跨部门"同名不同义" | 统一指标体系,口径集中管理,各方"说同一种语言" |
| 质量保障 | 缺乏统一的质量监控,问题靠事后发现 | 源头接入即清洗校验,质量全链路可监控 |
| 取数链路 | 每个 AI 应用独立对接各业务系统,重复开发取数接口 | 统一 API/指标服务,AI 应用按需调用即拿即用 |
六、AI 时代数据中台的"三重困境"应对
企业数据治理长期面临三大顽疾,中台化改造给出了体系化的解法。
数据口径不一致
同一指标在不同部门、不同报表中定义各异。中台通过统一指标体系和语义层,让全企业"说同一种数据语言"。
数据质量参差不齐
数据中台在接入源头即进行清洗、校验和监控,为 AI 应用提供可信数据底座,避免"垃圾进、垃圾出"。
数据获取链路过长
业务人员提需求、数据团队排队开发,动辄数周。中台将数据资产封装为标准化服务,AI 应用通过 API 即取即用,大幅缩短链路。
七、写给正在探索 AI 落地的企业
数据中台不是一堆技术组件的堆砌,而是企业数据资产化和服务化的过程。
在 AI 时代,它的价值不再是"支撑几张报表",而是决定了你的 AI 应用是"接在散乱的数据毛坯上",还是"长在干净、统一、可信的数据底座上"。
对于准备拥抱 AI 的企业而言,与其先采购一堆 AI 工具,不如先回答三个问题:
- 你的核心数据资产在哪里?
- 你的核心指标口径统一了吗?
- 你的数据能否被 AI 直接使用?
想清楚这三个问题,再谈 AI 落地,路径会清晰很多。
推荐阅读
如果您对数据中台的应用案例感兴趣,推荐阅读 Palantir 的官方文档(Palantir Foundry 文档)。Palantir 是一家上市以来股价涨了约 28.6 倍(发行参考价 7.25 美元 → 历史最高 207.52 美元)的军方信息化背景公司,其数据中台产品 Foundry 在全球范围内被广泛应用于大型企业的数据整合与 AI 应用,其文档中对数据 Ontology(本体)体系的设计思路有很多值得借鉴的理念。